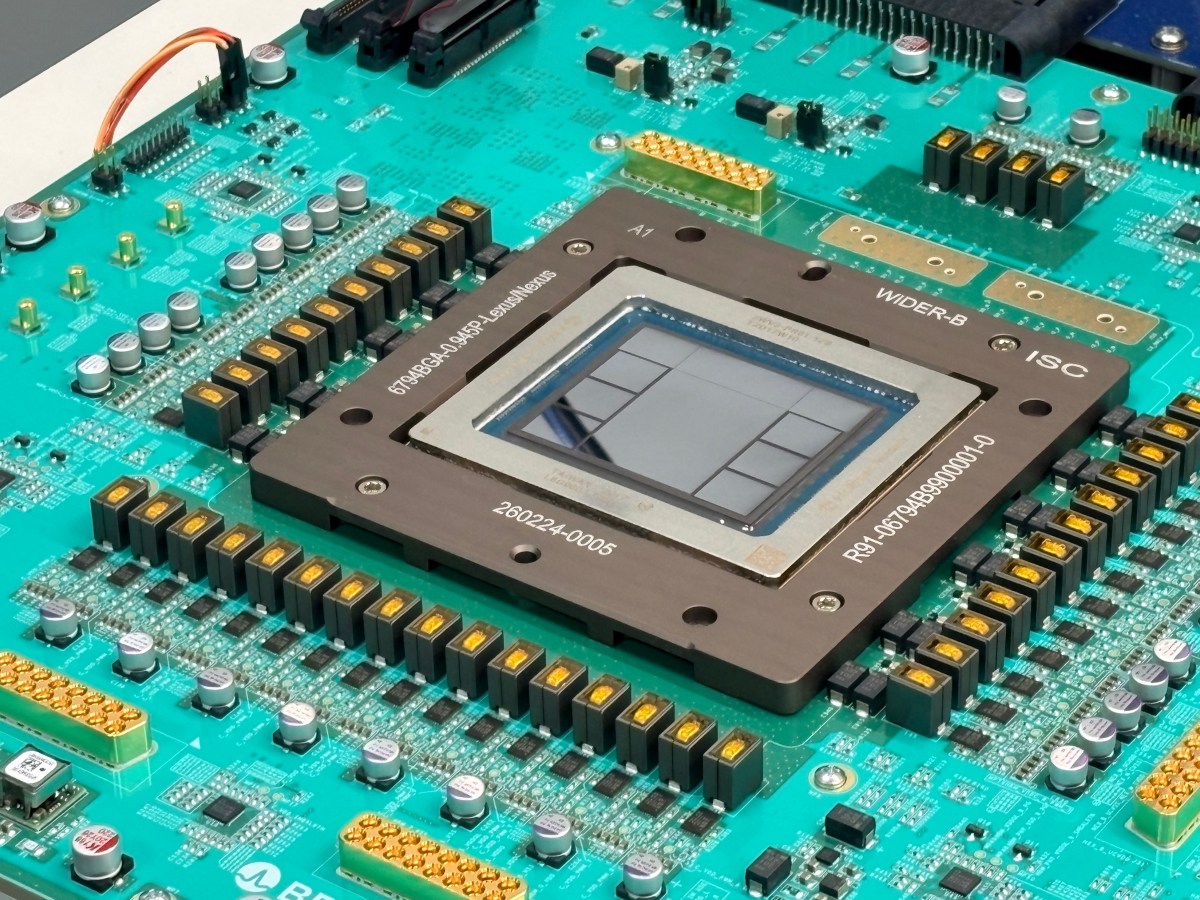
OpenAI Jalapeño, 추론 벤치마크에서 와트당 처리량 1.5~1.9배 주장
Jalapeño는 OpenAI가 챗봇이나 API가 답을 만들 때 쓰는 추론 응답 생성용으로 설계한 자체 칩이야. OpenAI는 8월 25일 이 칩의 첫 결과를 공개했어. SemiAnalysis의 공개 벤치마크 InferenceX에서 특정 비교 시스템과 견줘 피크 처리량 기준 와트당 AI 작업량이 1.51.9배 높고, 종단 간 지연시간은 1.73.6배 낮았다고 말해.
숫자가 가리키는 범위는 세 모델과 특정 비교 시스템이야
- 대상 모델: GPT-OSS 120B, DeepSeek R1, K2.5가 쓰였어.
- 측정 지표: InferenceX는 정해진 조건에서 처리량과 지연시간을 재는 공개 벤치마크야. 그래서 이 수치는 “그 조건에서 얼마나 효율적으로 돌았는가”를 보여주지만, 클라우드 운영비 전체를 바로 보여주는 계산서는 아니야.
- 일반화 한계: 실제 서비스 가격은 칩 효율만으로 정해지지 않아. 서버 대수, 네트워크, 예약 용량, 제품 가격 정책이 함께 들어가므로 이 결과만으로 모든 GPU보다 낫다거나 API 비용이 곧바로 내려간다고 읽으면 범위를 넘겨.
이번 발표가 6월 공개와 다른 점은 실제 측정값이 생겼다는 데 있어
6월에는 OpenAI와 Broadcom이 Jalapeño를 처음 소개하면서 추론에 맞춘 칩이라고 설명했어. 이번에는 공개 모델 세 개를 돌린 처리량·지연시간 수치가 붙었어. 다만 TechCrunch와 Tom’s Hardware 보도도 짚었듯, 배포 전 OpenAI가 공개한 자가 비교 결과라서 독립적인 다수 운영 환경 검증이나 장기 서비스 비용 결과와는 구분해야 해.
지금 볼 것은 칩 이름보다 배포 뒤 서비스 지표야
OpenAI는 2026년 말까지 Jalapeño를 자사 컴퓨팅 인프라에 배포하기 시작할 계획이라고 말해. API나 에이전트 서비스를 운영하는 팀이라면 벤치마크 순위만 보지 말고, 배포 뒤 실제 응답 지연시간·용량 제한·가격이 함께 바뀌는지 확인해봐. 칩의 와트당 효율은 그 변화가 가능한 조건이지만, 고객 가격을 보장하는 숫자는 아니야.