FrontierMath·ARC-AGI-3·ExploitBench 점수부터
“벤치마크 셋에서 98~100%를 찍은 모델인데, 토큰 값은 GPT-5.6 Sol의 2.5배야.” OpenAI가 GPT-6 Astra를 공개했어. 발표 글에 적힌 점수는 FrontierMath Tier 4 98%, ARC-AGI-3 99.9%, ExploitBench 100%야. 다만 i-SCOOP은 앞의 두 점수를 97.6%와 98.6%로 다르게 적었어. 소수 조직에 먼저 열고, 며칠에 걸쳐 ChatGPT Plus·Pro·Business·Enterprise와 OpenAI API, Microsoft Azure, AWS Bedrock까지 연다고 적혀 있어.
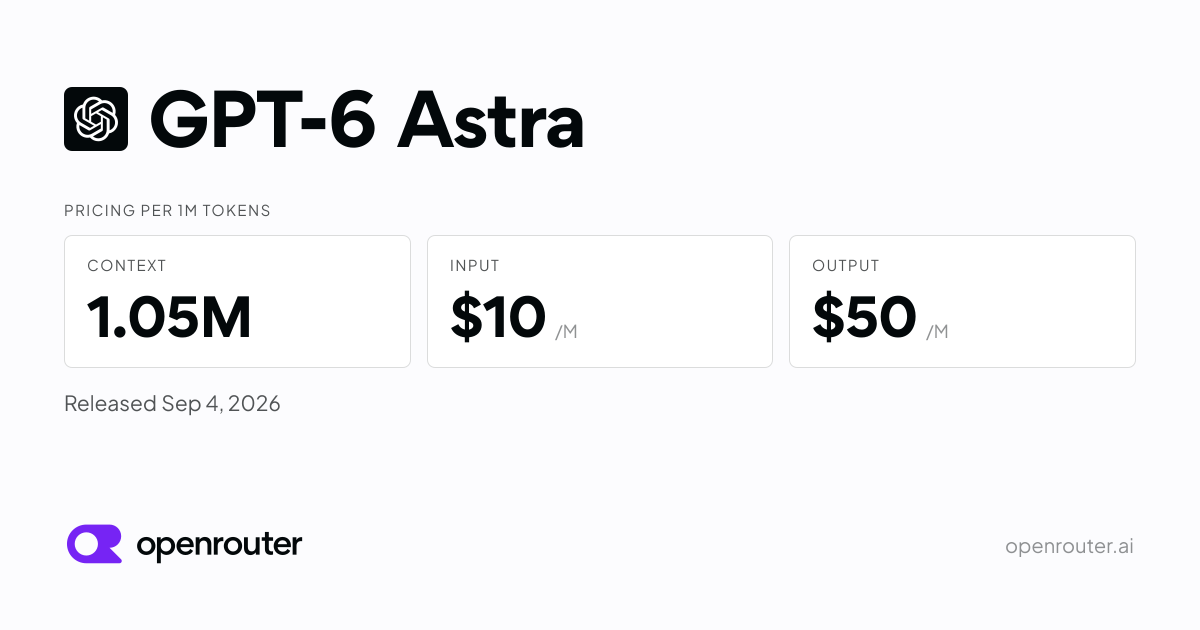
값은 입력 $10, 출력 $50이야
- 표준 단가: 100만 토큰당 입력 $10, 출력 $50. GPT-5.6 Sol의 2.5배야.
- 한도: 컨텍스트 창은 105만 토큰, 한 번에 받는 출력은 12만 8천 토큰까지야.
- Fast 모드: i-SCOOP 집계로는 표준 대비 단가가 2배야.
단가만 보면 옮길 이유가 없어 보이는데, OpenAI가 내민 숫자는 반대야.
작업당 비용은 오히려 낮다는 게 OpenAI 계산이야
OpenAI가 점수를 견준 벤치마크 중 하나가 Terminal-Bench Science 0.1이야. 여기서 Astra는 64.6%, Claude Fable 5.1은 52.6%인데 추정 API 비용은 약 31% 낮았다고 발표 글에 적혀 있어. 저비용 설정에서는 Astra 61.1%, GPT-5.6 Sol 22.4%에 추정 비용 약 27% 낮음이고.
단가는 2.5배인데 작업당 추정 비용은 낮다는 두 숫자가 같이 온 거야. 이 비용은 OpenAI가 자기 조건에서 낸 추정치고, 같은 계산을 재현한 외부 결과는 아직 없어.
범위 이탈 평가는 48%에서 0%로 적혔어
운영 안전장치 없이 돌렸을 때 모델이 허가된 대상을 넘는지 보는 OpenAI 자체 평가가 발표 글에 같이 실렸어. GPT-5.6 Sol이 48%였고 Astra는 0%였다고 적었어.
정렬 평가를 OpenAI가 직접 설계했다는 조건은 그대로 남아. 0%는 이 평가 안에서의 0%야.
도입 전에 확인할 것
- 비용: 지금 돌리는 작업의 출력 토큰 수로 다시 계산해. 100만 출력 토큰당 $50은 Sol 쓰던 청구서를 2.5배로 만들어.
- 점수 출처: 위 점수는 전부 OpenAI 발표 기준이야. i-SCOOP은 OpenAI 차트가 Claude Fable 5.1을 67.4%로 놓고 Muse를 뺐다고 지적했고, FrontierMath 운영사 Epoch AI가 OpenAI 자금을 받고 문제 일부에 OpenAI가 접근한다는 점도 같이 적었어.
- 수치 불일치: 같은 i-SCOOP 기사는 FrontierMath Tier 4를 97.6%, ARC-AGI-3를 98.6%로 적어 발표 글의 98%·99.9%와 어긋나. 어느 쪽이 최종 표기인지 확인해 주는 문서를 아직 못 찾았으니, 제목의 98~100%는 확정된 값이 아니라 발표 글 기준으로 읽어.
- 접근 순서: 소수 조직이 먼저라 일반 API 키로 바로 열리는 건 아니야.
벤치마크가 100%라고 내 작업이 100%가 되는 건 아니거든. 급할 거 없어.